
Claude inserirà un watermark invisibile per davvero? Questa è la grande domanda che molti si pongono, e che tutti danno per sbagliata. Non ci saranno “parole invisibili”, non ci sarà un marchio misterioso, ma più una sorta di codice.
È più facile a farsi che a spiegarsi, anche se Anthropic, il produttore del noto LLM, ci prova. È più una sorta di codice segreto ma non troppo, l’equivalente virtuale della safeword in un gioco erotico o un segnale segreto tra amici.
E richiede la conoscenza dei meccanismi su come funzionano gli LLM
Claude inserirà un watermark invisibile per davvero? È più facile a farsi che a spiegarsi
Abbiamo già visto in un precedente articolo come un testo costruito da un LLM può essere identificato da due tratti che però sono comuni anche ad alcuni tipi di produzioni letterarie di elevata specializzazione (come i testi giuridici e religiosi): i parametri della perplessità e della rapidità.
L’esempio è la frase “Potresti offrirmi una tazza di…?”. Statisticamente parlando, le frasi più comuni sono “Una tazza di caffé”, “una tazza di the”, ma è improbabile un testo possa mai contenere “Una tazza di ragni” o “una tazza di petrolio greggio”, e quindi avrà un indice di perplessità elevato. Quindi l’indice di perplessità porterà alla classificazione come contenuto originale. Altro concetto è la rapidità: in inglese burst. Leggete questo stesso testo: in alcuni punti vengono usate frasi più lunghe, in altre più corte. Alcune strutture sintattiche si ripetono: un bravo scrittore cerca sempre di non avere periodi di testo troppo lunghi, per evitare l’effetto “rantolo di Nonno Simpson”, il noto personaggio della serie americana che racconta storie includenti con capoversi che cominciano da un evento e finiscono da tutt’altra parte.
Non è automatico (segnate questa parte, è importante) che un testo costruito in modo perfettamente stastistico e con un ritmo perfetto sia costruito da una Intelligenza Artificiale. Un testo normativo o scientifico ad esempio seguirà entrambe le regole, e il compito in classe di uno studente potrebbe avere nella traccia l’invito a seguire perfettamente una determinata forma: ad esempio invitando lo studente a mantenere i propri paragrafi brevi e usare un determinato linguaggio per determinati voti.
Anche diverse testate online presentano un “sillabo”, una lista dettagliata di temi da affrontare per essere presi in considerazione per eventuali contributi, nonché un obbligo di forma per armonizzare i contenuti tra i vari scrittori: un testo creato con AI avrà certamente bassa perplessità e un ritmo fissato, ma anche molti contenuti prodotti da un essere umano li hanno, e questo è la fonte di infiniti falsi positivi.
Passiamo ora al tentativo di Anthropic, che si basa proprio sul piegare la perplessità.
Come funziona davvero il marchio invisibile?
Non vi saranno watermark, non ci saranno testi invisibili: semplicemente in sede della selezione statistica Claude sceglierà alcune parole rispetto ad altre, “preconcordate da un seme”, ovvero un sistema algoritmico, senza che infici il senso o il tono del discorso.
Un po’ come in un gioco erotico si può decidere ad esempio di usare la parola “catafalco” per interrompere un gioco di ruolo senza uscire dal personaggio, Claude potrebbe, in un esempio citato nel testo di presentazione, decidere che laddove avrebbe composto una frase sul tempo scrivendo “Era un notte buia e nuvolosa”, potrebbe invece usare “Era una notte buia e nebulosa” o “uggiosa” o un arcaismo che suona bene nel contesto ma può essere usato.
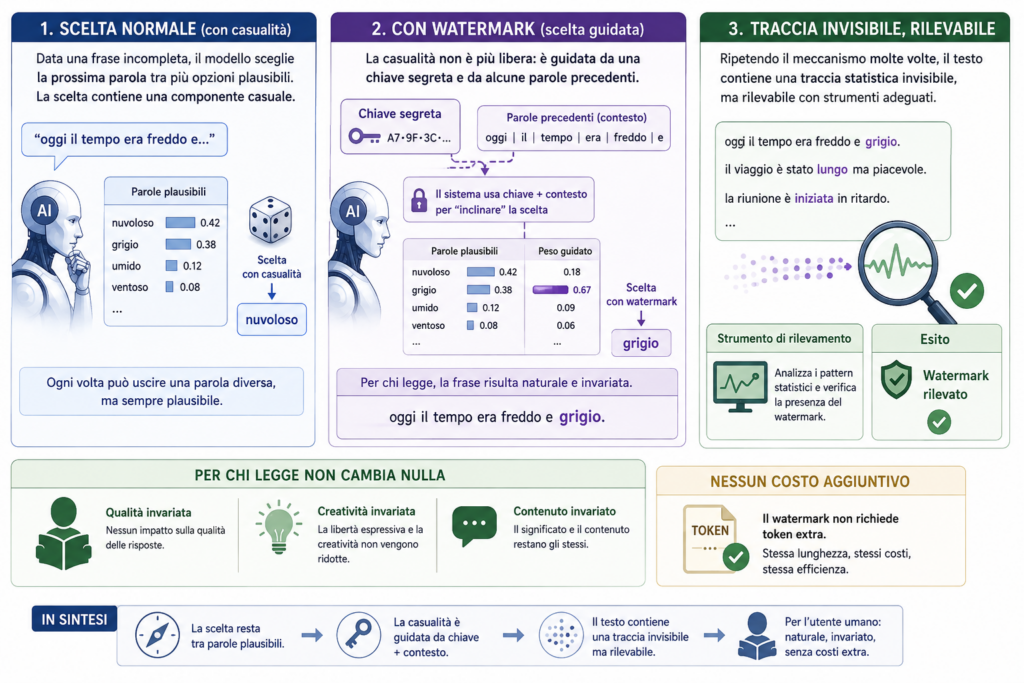
Ma senza ovviamente rendere trasparente all’utente dove la parola “segreta” viene piazzata nel testo, ipoteticamente costringendo chi volesse sfuggire al controllo a riscrivere il testo, e il tutto senza aggravi di token usati, quindi senza consumare maggiori risorse e senza chiedere all’utente pagamenti per servizi superiori.
Sì, ma quanto è efficace?
Anthropic stesso lo ammette: il sistema ha dei limiti enormi.
Sicuramente tutto è meglio di niente, ma il primo limite è che il segnale invisibile non può essere inserito in ogni frase.
Ipotizziamo che qualcuno chieda un brevissimo testo che riassuma o traduca un altro testo con bibliografia. Claude avrebbe già poco spazio, e non potrebbe ad esempio cambiare i titoli dei libri citati per inserire una “parola del mistero” in modo surrettizio oppure non potrebbe inficiare la qualità del testo (perché il sistema non prevede questo) per inserire il watermark.
Il watermark non funziona su piccoli testi, dove ci sono meno informazioni da diffondere, ribadisce il testo, e siccome non può influenzare la qualità delle informazioni, pensiamo al caso in cui si interpreti l’LLM per fare raccolta ed elaborazione dati. “Due più due” farà sempre quattro, a meno che il testo non sia un riassunto della scena di 1984 di Orwell in cui i personaggi asseriscono che su ordine del Grande Fratello potrebbe fare cinque.
Il watermark non impedisce che il testo sia “umanizzato” riscrivendolo da zero, pratica di molti studenti svogliati già prima del watermark.
Il watermark non funzionerà nel caso l’utente si limiti a produrre un suo testo e chiedere a Claude di ricorreggerlo e riscriverlo, dato che in quel caso dovrà combattere coi parametri inseriti dall’utente.
Potranno quindi esserci testi creati con AI in cui il watermark non ha funzionato e testi creati da umani che però contengono piccole sezioni create da AI o per puro caso (infinitesimo ma possible) una sintassi che tragga in inganno, come abbiamo già visto.
Il sistema è di compliance: si cerca di creare qualcosa che in base all’AI Act possa aiutare a riconoscere la AI, ma non è la panacea.